GEO-оптимизация сайта: что входит и сколько стоит

На техническую GEO-оптимизацию готового сайта с доступом к коду и журналу сервера я закладываю 5–18 часов. Ставка на октябрь 2026 года 155 или 4 000 ₽ в час, итого 775–2 790 или 20 000–72 000 ₽ разово.
Я проверяю, могут ли ИИ-боты прочитать сайт, исправляю доступ, картинки, разметку и карту сайта, затем разбираю журнал запросов к серверу. Пять часов уходят на проверку доступа и два среза журнала. Тексты, публикации на других площадках и замер ответов нейросетей сюда не входят.
Результат сдаю проверками исправленных адресов. Попадание в ответы ChatGPT или Алисы я не обещаю: кого процитировать, решает ассистент.
Состав работ, часы и цена
1. Проверка доступа
robots.txt, ответ боту, текст без JavaScript, защита хостинга. Итог: отчёт по 5–10 адресам
2 ч, 310 BYN
2. Правки доступа
Правила robots.txt для выбранных ботов и адресов. Приёмка: страницы и картинки разрешены, сервер отдаёт их содержимое
1–2 ч, 155–310 BYN
3. Картинки
Картинки по постоянным адресам, их берут и боты ассистентов. Приёмка: список адресов, ответы 200 и типы файлов
2–4 ч, 310–620 BYN
4. Разметка JSON-LD
Схемы статьи, автора и вопросов, до трёх типов страниц, для обычного поиска. Приёмка: валидатор и сверка данных со страницей
3–5 ч, 465–775 BYN
5. Карта сайта
Согласованные страницы и картинки в sitemap.xml, отправка в Вебмастер и Search Console. Приёмка: список адресов и статус обработки карты
1–2 ч, 155–310 BYN
6. Журнал сервера
Два среза: до работ и через месяц. Приёмка: отчёт о запросах ботов со сверкой IP
3 ч, 465 BYN
Итого
Работа 1 всегда, 6 при доступе к журналу, 2–5 по итогам проверки
5–18 ч, 775–2 790 BYN
Расчёт относится к готовому сайту на своём хостинге, с доступом к коду и журналу. Объём растёт, если нужно разбирать защиту хостинга, править разные типы страниц или работать с картинками на стороннем сервисе. После проверки называю состав работ и точную сумму. Без доступа к журналу состав и стоимость согласуем отдельно.
Среди десяти предложений, найденных поиском 15 октября 2026 года, была разметка одной главной страницы за 15 000 ₽ разово. Сопровождение начиналось от 50 000 ₽ в месяц и обычно включало тексты, публикации на других площадках и замер ответов. Сравнивайте состав работ.
Что не входит и почему
Попадание в ответы. Для ИИ-обзоров Google страница должна быть в индексе и иметь право на сниппет, то есть на текстовое описание в выдаче. Особые файлы и специальная разметка для этого не требуются, так пишет сам Google. Разметку из работы 4 я добавляю для обычного поиска. Если нужные данные уже размечены верно и совпадают с содержимым страницы, доработка не нужна.
Упоминания на других площадках. Я считаю их главным рычагом GEO, но такую услугу не оказываю. С чего начать самостоятельно, разобрано в статье о трёх факторах.
llms.txt отдельной строки не получает, причина ниже, в журнале.
Тексты и переделка сайта оплачиваются отдельно. Если сайт дорисовывает текст в браузере, сначала нужна серверная отрисовка, а это разработка.
Как отличить работу от обещаний
Если выбираете исполнителя или уже оплачиваете сопровождение, попросите:
- Цену за период и состав работ, который можно пересчитать при сдаче: страницы, публикации, проверки.
- Для замера упоминаний: запросы, сервисы, режимы поиска и ответы с датами до начала работ. В отчёте нужны те же запросы и условия. Долю упоминаний гарантировать нельзя.
- Техническую часть, которую можно проверить без исполнителя, хотя бы командами из конца статьи.
- Отчёт о ботах со сверкой IP: с 24 сентября по 7 октября все 2 632 запроса к нам с именем GPTBot пришли не от OpenAI.
- Что оплачивается сверху: тексты, публикации, сервис замера.
Что из сметы сделано на fomenko.by
6 сентября мы открыли картинки в robots.txt, 7 сентября заменили перенаправления выдачей файлов, 8 сентября записей о картинках в карте сайта стало 111 вместо 39. Разметку добавляли в мае и августе.
Поломку с картинками снаружи не было видно: страницы открывались, а картинки статей лежат по адресам /api/media/, и строка Disallow: /api/ закрывала их от всех роботов. Нашлась она запросом адреса картинки.
Время по шести работам не записано. Между выгрузкой журнала и готовым анализом 8 октября прошло 52 минуты по меткам файлов. Часы сметы остаются расчётными: на чужом сайте добавляются доступы, незнакомый код и отчёт.
Что показала приёмка на нашем сайте
15 октября мы повторили проверки для приёмки. Все 222 разных адреса картинок из карты сайта ответили 200 с типом картинки, без перенаправлений: это приёмка работы 3. Search Console скачал карту 14 октября, ошибок и предупреждений ноль, в ней 102 страницы и 273 записи о картинках: приёмка работы 5.
# выдержка из ответа Search Console API, 15.10.2026
# поле contents[].indexed не взято: в документации API
# оно помечено «Deprecated; do not use»
"path": "https://fomenko.by/sitemap.xml",
"lastDownloaded": "2026-10-14T12:02:19.207Z",
"warnings": "0",
"errors": "0",
"contents": [
  { "type": "web", "submitted": "102" },
  { "type": "image", "submitted": "273" }
]
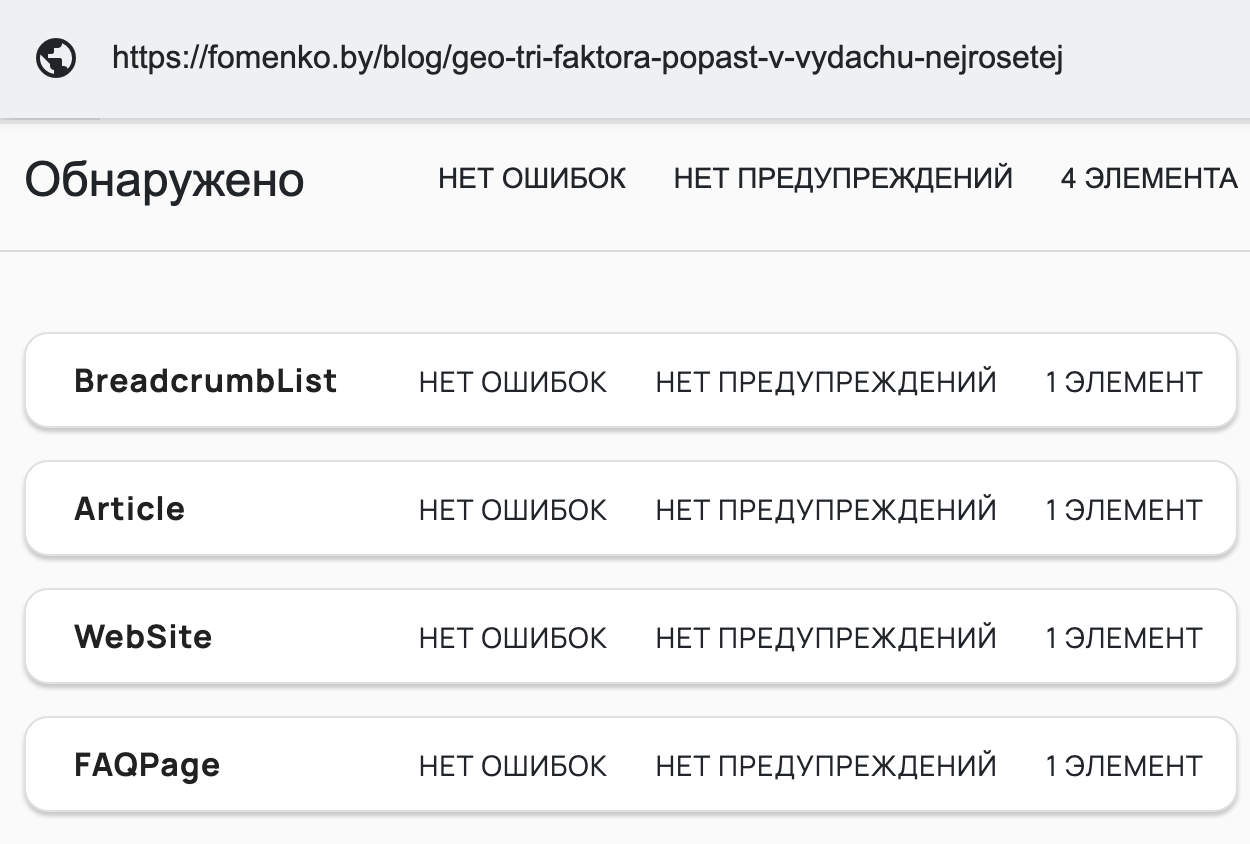
Разметку статьи проверил валидатор schema.org, это первая половина приёмки работы 4. Вторая половина, сверка данных с текстом страницы, делается глазами.
Что показал журнал за неделю
Ответ на нашу команду ещё не подтверждает визит бота. В работе 6 мы проверяем журнал сервера: сверяем IP-адрес каждого запроса со списком владельца бота. Результаты за 8–14 октября:
PerplexityBot
342
307 ответов на 43 разные страницы, 9 картинок, robots.txt
OAI-SearchBot, поиск ChatGPT
52
только robots.txt
ChatGPT-User, по просьбе человека в чате
5
5 страниц
GPTBot и ClaudeBot
0
все строки с чужих адресов
Страницы забирали PerplexityBot и ChatGPT-User. Поисковый бот ChatGPT читал только robots.txt. Причину журнал не показывает, а отсутствие запросов к страницам само по себе не доказывает ошибку настройки.
Файл llms.txt, оглавление сайта для нейросетей, запросили 13 раз: 6 запросов наши, остальные пришли с именами браузеров и сервисов проверки сайтов. Подтверждённых запросов ботов ассистентов нет, хотя PerplexityBot за ту же неделю забрал 43 страницы.
Как заказать
Отдельного тарифа GEO нет: это часы разработки, строка «Доработка готового сайта» на странице разработки сайтов. Пришлите через форму на главной адрес сайта, 5–10 важных страниц и скажите, есть ли доступ к хостингу и журналу сервера. Работаю удалённо, в том числе с Россией.
Начать можно с команд ниже: они покажут грубые поломки на выбранных адресах, но не заменят проверку всего сайта.
Как повторить проверку
Подставьте адреса страницы и картинки и фразу из текста, сохраните команды в audit.sh и запустите bash audit.sh. Блок ищет запрет всего сайта, фразу вне скриптов и названия схем. Все правила robots.txt и правильность разметки он не проверяет. Подробные шаги и команда для журнала есть в статье про ИИ-бота, который не видит сайт.
SITE=https://fomenko.by
PAGE=$SITE/blog/geo-tri-faktora-popast-v-vydachu-nejrosetej
IMG=$SITE/api/media/fomenko/blog/geo-tri-faktora/dostup.jpg  # картинка с этой страницы
TEXT='Попасть в выдачу нейросетей значит'                    # фраза из текста страницы
UA='Mozilla/5.0 (compatible; OAI-SearchBot/1.3; +https://openai.com/searchbot)'

curl -s "$SITE/robots.txt" | tr -d '\r' | awk -F': *' 'tolower($1)=="user-agent"{if(r){ua="";r=0}; ua=ua" "$2; next} /^[A-Za-z-]+:/{r=1} tolower($0)~/^disallow: *\/ *$/{print "Disallow: / в группе:" ua}'  # 1
curl -s -A "$UA" -o page.html -w '%{http_code}\n' "$PAGE"                            # 2
perl -0pe 's#<script\b.*?</script>##gis' page.html | grep -cF "$TEXT"                 # 3
grep -oE '"@type": ?"[A-Za-z]+"' page.html | sort | uniq -c                          # 4
curl -sI -A "$UA" "$IMG" | grep -iE '^(http|content-type|cache-control|location)'    # 5
curl -s "$SITE/sitemap.xml" | grep -o '<url>' | wc -l                                # 6
curl -s "$SITE/sitemap.xml" | grep -o '<image:image>' | wc -l
curl -s -o /dev/null -w '%{http_code} %{size_download}\n' "$SITE/llms.txt" # 7# 1. Запрет всего сайта: только SEO-сервисам
Disallow: / в группе: AhrefsBot
Disallow: / в группе: SemrushBot
Disallow: / в группе: MJ12bot
Disallow: / в группе: DotBot
Disallow: / в группе: BLEXBot
Disallow: / в группе: serpstatbot
# 2. Ответ страницы боту
200
# 3. Строк с фразой вне скриптов
1
# 4. Типы разметки (фрагмент);
# правильность проверяет валидатор
1 "@type":"Article"
1 "@type":"BreadcrumbList"
1 "@type":"FAQPage"
1 "@type":"Person"
# 5. Заголовки картинки: файл,
# без перенаправления
HTTP/2 200
content-type: image/jpeg
# 6. Страниц и записей о картинках
102
273
# 7. llms.txt, необязательно
200 28980Коротко
Читайте также
Почему ИИ-бот не видит сайт: проверка по логам
Как найти, что мешает ИИ-боту забрать страницу или картинку: robots.txt, ответ сервера, журнал. Наш случай и срез журнала за две недели.
Сколько стоит Telegram-бот: смета одной задачи
Смета Telegram-бота с нуля: 27-38 часов, 4 185-5 890 BYN. Сколько добавит панель Mini App и что оплачивать, если начать с готового бесплатного шаблона.
Как попасть в выдачу нейросетей
Почему ChatGPT и Алиса не советуют ваш сайт и как это исправить. Три фактора попадания в выдачу нейросетей: доступ боту, упоминания, свежесть модели.