
Оставайтесь на Тильде, пока её штатные функции закрывают ваши задачи. Если функции не хватает, проверьте, можно ли достроить её кодом рядом. Переезд на сайт на коде стоит считать, когда поддержка этой связки стала постоянной работой. Сравнивайте расходы обоих вариантов за один срок, включая поддержку после переезда.
Ориентир на разработку нового сайта услуг у меня 28-50 часов, магазина 60-110. Перенос содержимого, адресов и своих доработок оценивается отдельно. Ниже интернет-магазин на Тильде в двух странах, который я веду и достраиваю кодом.
Что Тильда делает сама и когда уходить не нужно
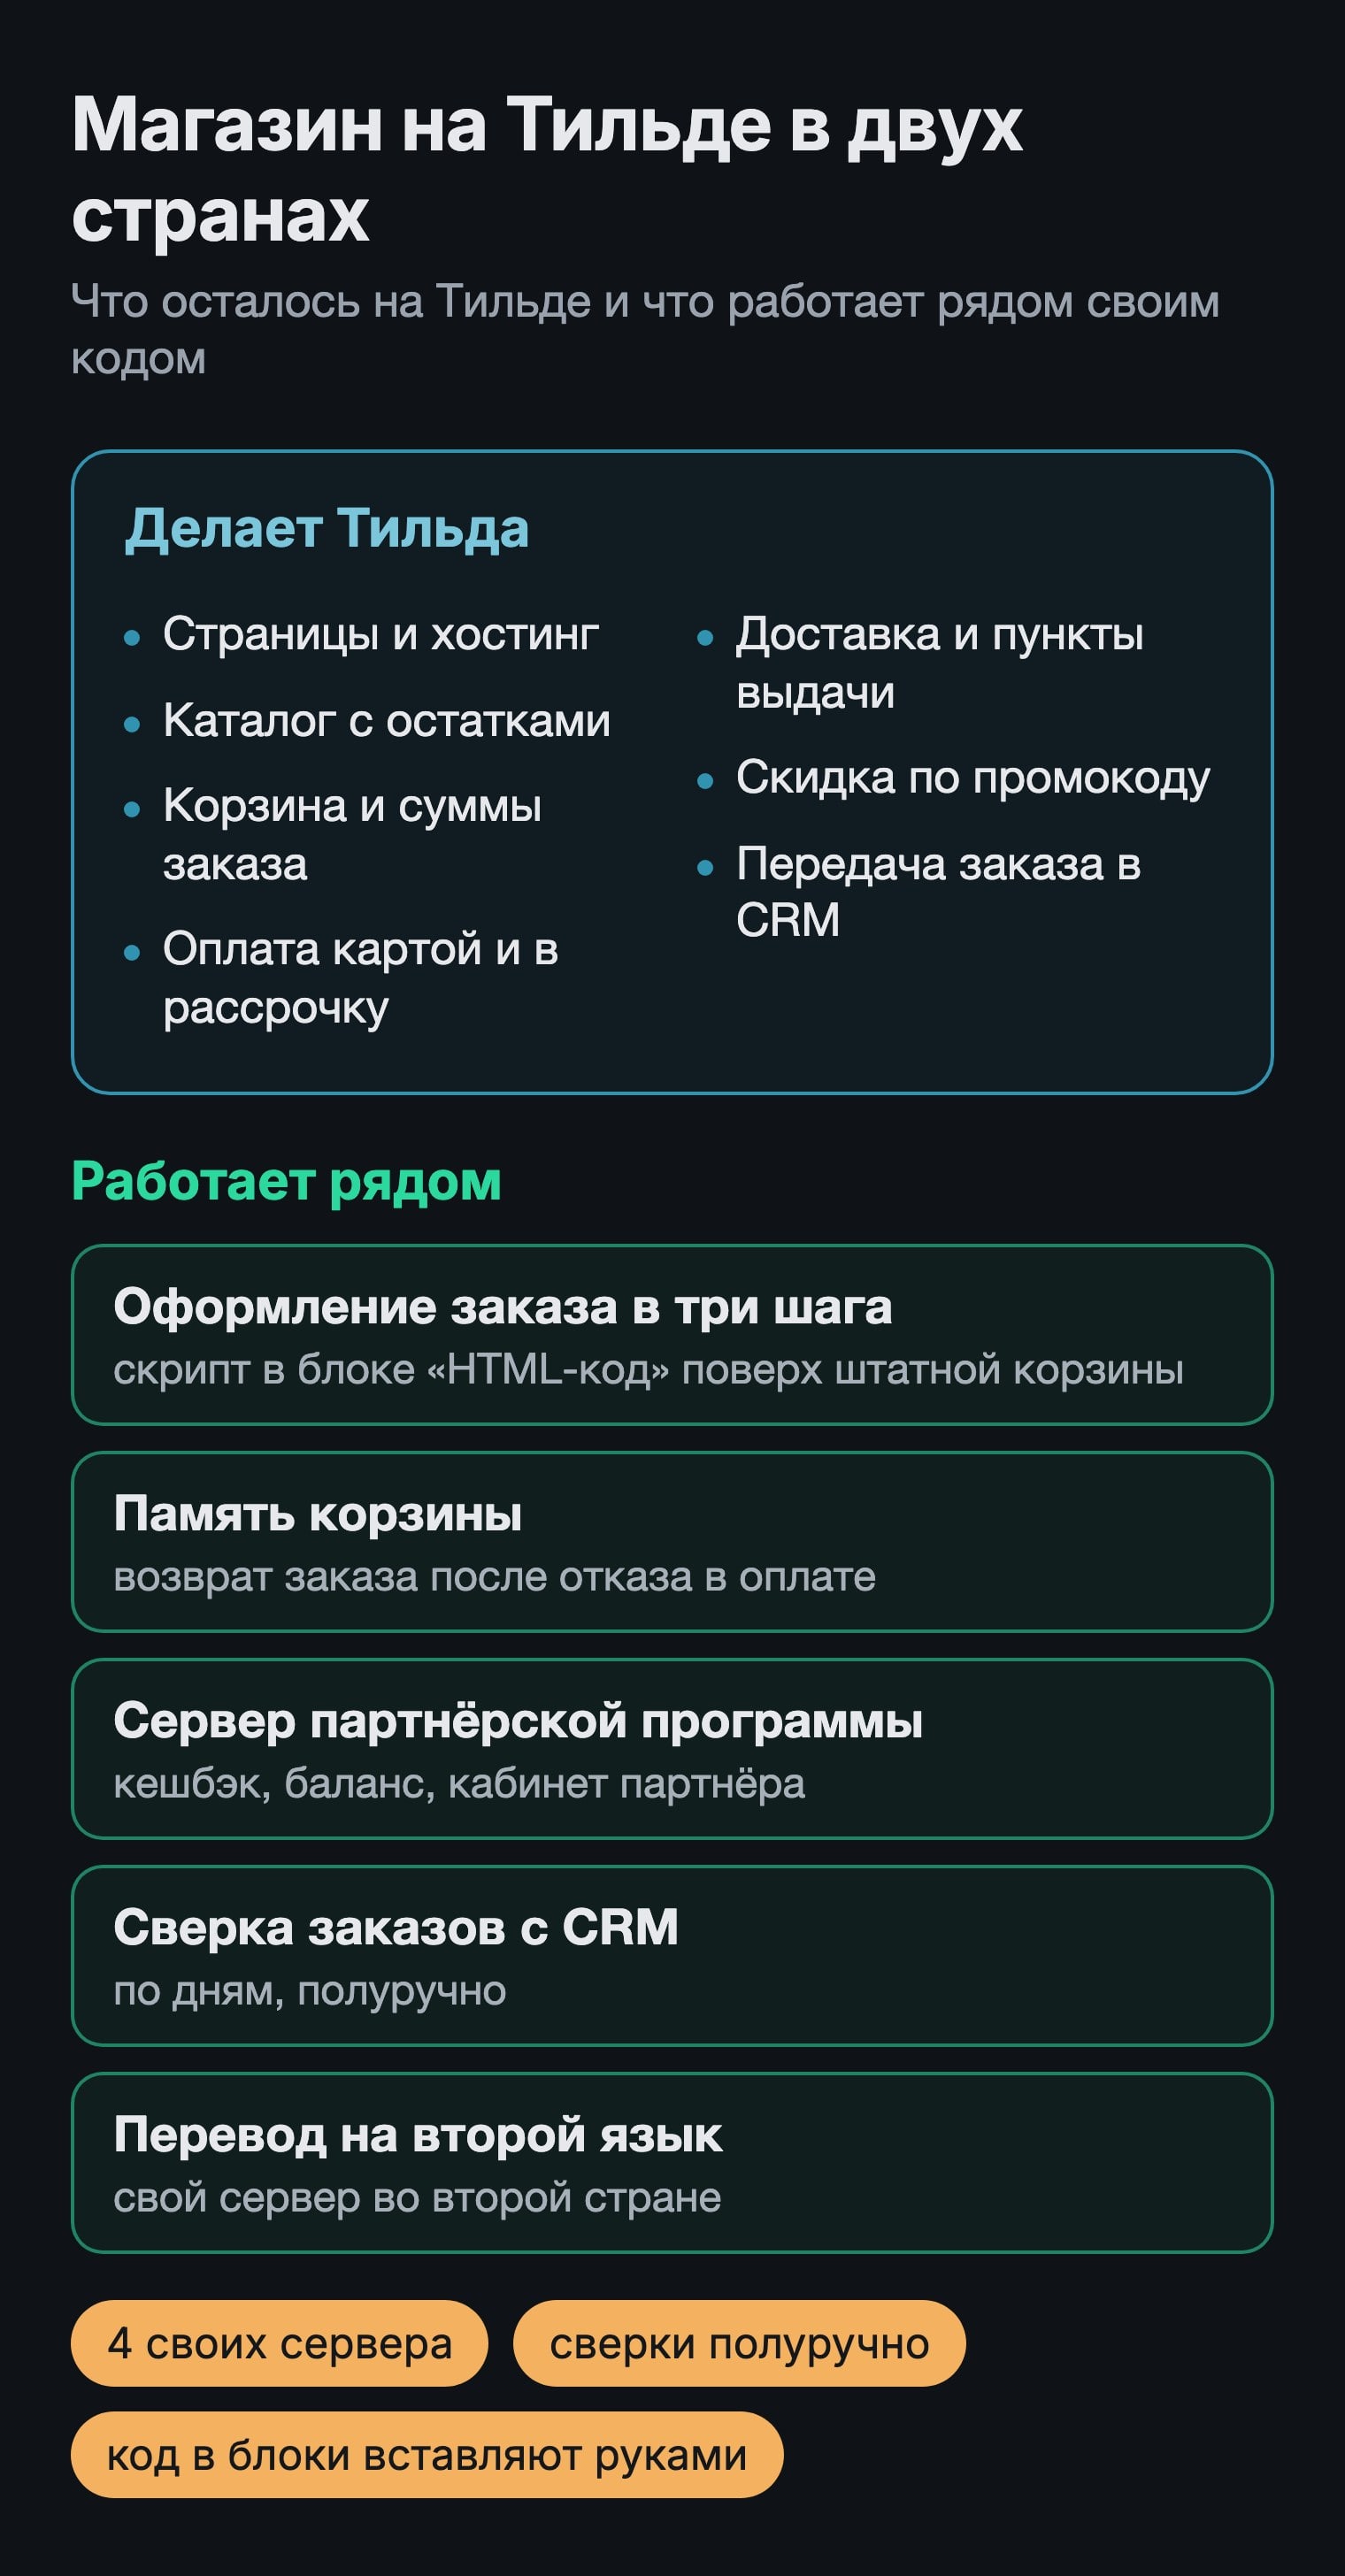
В этом магазине Тильда отвечает почти за всё, что видит покупатель: страницы, каталог, корзину, оплату, доставку, промокоды и передачу заказа в CRM. Команда магазина правит страницы сама.
На русскоязычной странице тарифов 22 октября 2026 года Personal указан по 500 ₽ в месяц при оплате за год: 1000 страниц, до 5000 товаров. В блок «HTML-код» можно вставить HTML, CSS и JavaScript. Для серверного кода и базы данных нужна отдельная площадка. Если сайту хватает этого набора, переезд добавит расходы и не решит новых задач.
Минусы и ограничения Тильды, которые магазин обходит своим кодом
Тильда делает даже закрытые страницы для своих. Граница там, где у каждого клиента появляются свои данные.
Заказ в три шага
Штатная корзина открывается одним окном; цену до скидки добавили отдельно
Скрипт в блоке «HTML-код» поверх штатной корзины
Корзина после отказа в оплате
При рассрочке по ссылке корзина очищалась до перехода к оплате
Свой блок помнит корзину, промокод и доставку
Партнёрская программа
Промокод даёт только скидку
Свой сервер считает кешбэк, баланс и ведёт кабинет партнёра
Заказы в CRM
Заказы выгружают через кабинет, повторно отправить заявку нельзя
Свой скрипт сверяет заказы со сделками по дням
Второй язык
Пришлось бы отдельно вести страницы, каталог и корзину
Свой сервер во второй стране подставляет перевод из словаря
Один только заказ в три шага планировали на 7-11,5 дня работы, а правки к нему шли с августа до октября. Вне Тильды работают четыре своих сервера и сторожа, которые шлют тревогу при сбое. Чтобы поправить шапку одного из сайтов, 57 страниц переопубликовывают по одной: кнопка «Опубликовать все» выложила бы и чужие черновики. Про обмен заказами с CRM есть отдельный разбор.
Где ломается связка Тильды и своего кода
В конце августа в оформление заказа добавили защиту от заказа без выбранной доставки. Код выложили на сайт, но версию не сохранили в репозитории, хранилище истории изменений. При отмене другого черновика защиту стёрли из исходников.
Разницу заметили через неделю: код на сайте был на 2,2 КБ больше сохранённого. Перезапись вернула бы ошибку: в заказ попадала бы платная доставка, которую покупатель не выбирал. Рабочую версию нашли в истории правок ИИ-ассистента, которым пишется этот код. Теперь перед заменой сверяем код на сайте с сохранённой версией. Такая ошибка возможна и на своём сервере, но там выкладку можно разрешить только из репозитория, а в Тильду код вставляют руками.
Другой сбой начался со сканера: наш сервер перевода пересылал его запросы Тильде и попал под блокировку. Сайты второй страны около 15 минут показывали ошибку. При подготовке статьи мы тоже получили блокировку с ответом 410 после нескольких десятков запросов. При сборе старых адресов такой ответ нужно перепроверять: программа может принять страницу за удалённую.
Признаки, что пора считать переезд
- Рядом с Тильдой работает свой сервер, и через него идут заказы, деньги или данные клиентов.
- Одно и то же живёт в двух местах (промокод, заказ), и это приходится сверять.
- Нужен второй язык, а копии страниц под каждый язык уже не справляются.
- Код в блоках правят мимо репозитория, и рабочую версию уже теряли.
- Мелкая правка требует переопубликовать десятки страниц.
Оцените каждый пункт в часах и сравните два бюджета на год: Тильда с доработками и поддержкой против переезда с поддержкой после него, в обоих с серверами и работой команды. Магазин из примера живёт на Тильде при всех пяти признаках; часы его поддержки не записаны, поэтому окупаемость переезда здесь не считаем.
Сколько стоит переезд с Тильды
Ставка у меня одна: 155 (55 USD, 4 000 ₽) в час. На странице разработки сайтов опубликованы ориентиры на новый сайт:
- сайт услуг на 5-10 страниц: 28-50 часов, 4 340-7 750 ;
- интернет-магазин с оплатой: 60-110 часов, 9 300-17 050 .
Перенос содержимого, старых адресов, партнёрской программы, второго языка и обмена с CRM оцениваю отдельно: часть кода переезжает, часть пишется заново. Новые сайты я собираю с ИИ-агентом: пример с проверкой.
В смете закрепите, как команда будет менять страницы после переезда. К разработке добавьте хостинг и поддержку: эти расходы останутся после запуска.
Как перенести сайт с Тильды и проверить результат
- До переключения сохраните карты сайта: sitemap.xml, sitemap-store.xml с товарами и sitemap-feeds.xml с постами, если они есть.
- Сохраните домен и прежние адреса. Для изменённых адресов составьте таблицу «старый → новый» и настройте 301 на новом сервере. Учитывайте адреса /page…, /tproduct/… и /tpost/….
- Перенесите тексты, изображения, заголовки и описания страниц. Проверьте, что новый сайт открыт для индексации.
- Выгрузите каталог в CSV и заявки: по умолчанию Тильда хранит их месяц. Договоритесь о заказах, пришедших во время подготовки.
- До переключения отправьте заявку с каждой формы и оплатите тестовый заказ. Проверьте, что заявка пришла и оплата прошла.
- Перенесите счётчики и цели, проверьте события.
- Проверьте старые адреса на новом сервере до переключения и повторите после. Затем смотрите ошибки обхода в Вебмастере и Search Console.
- Сохраните возможность вернуть домен на Тильду. Подписку отменяйте после проверки нового сайта.
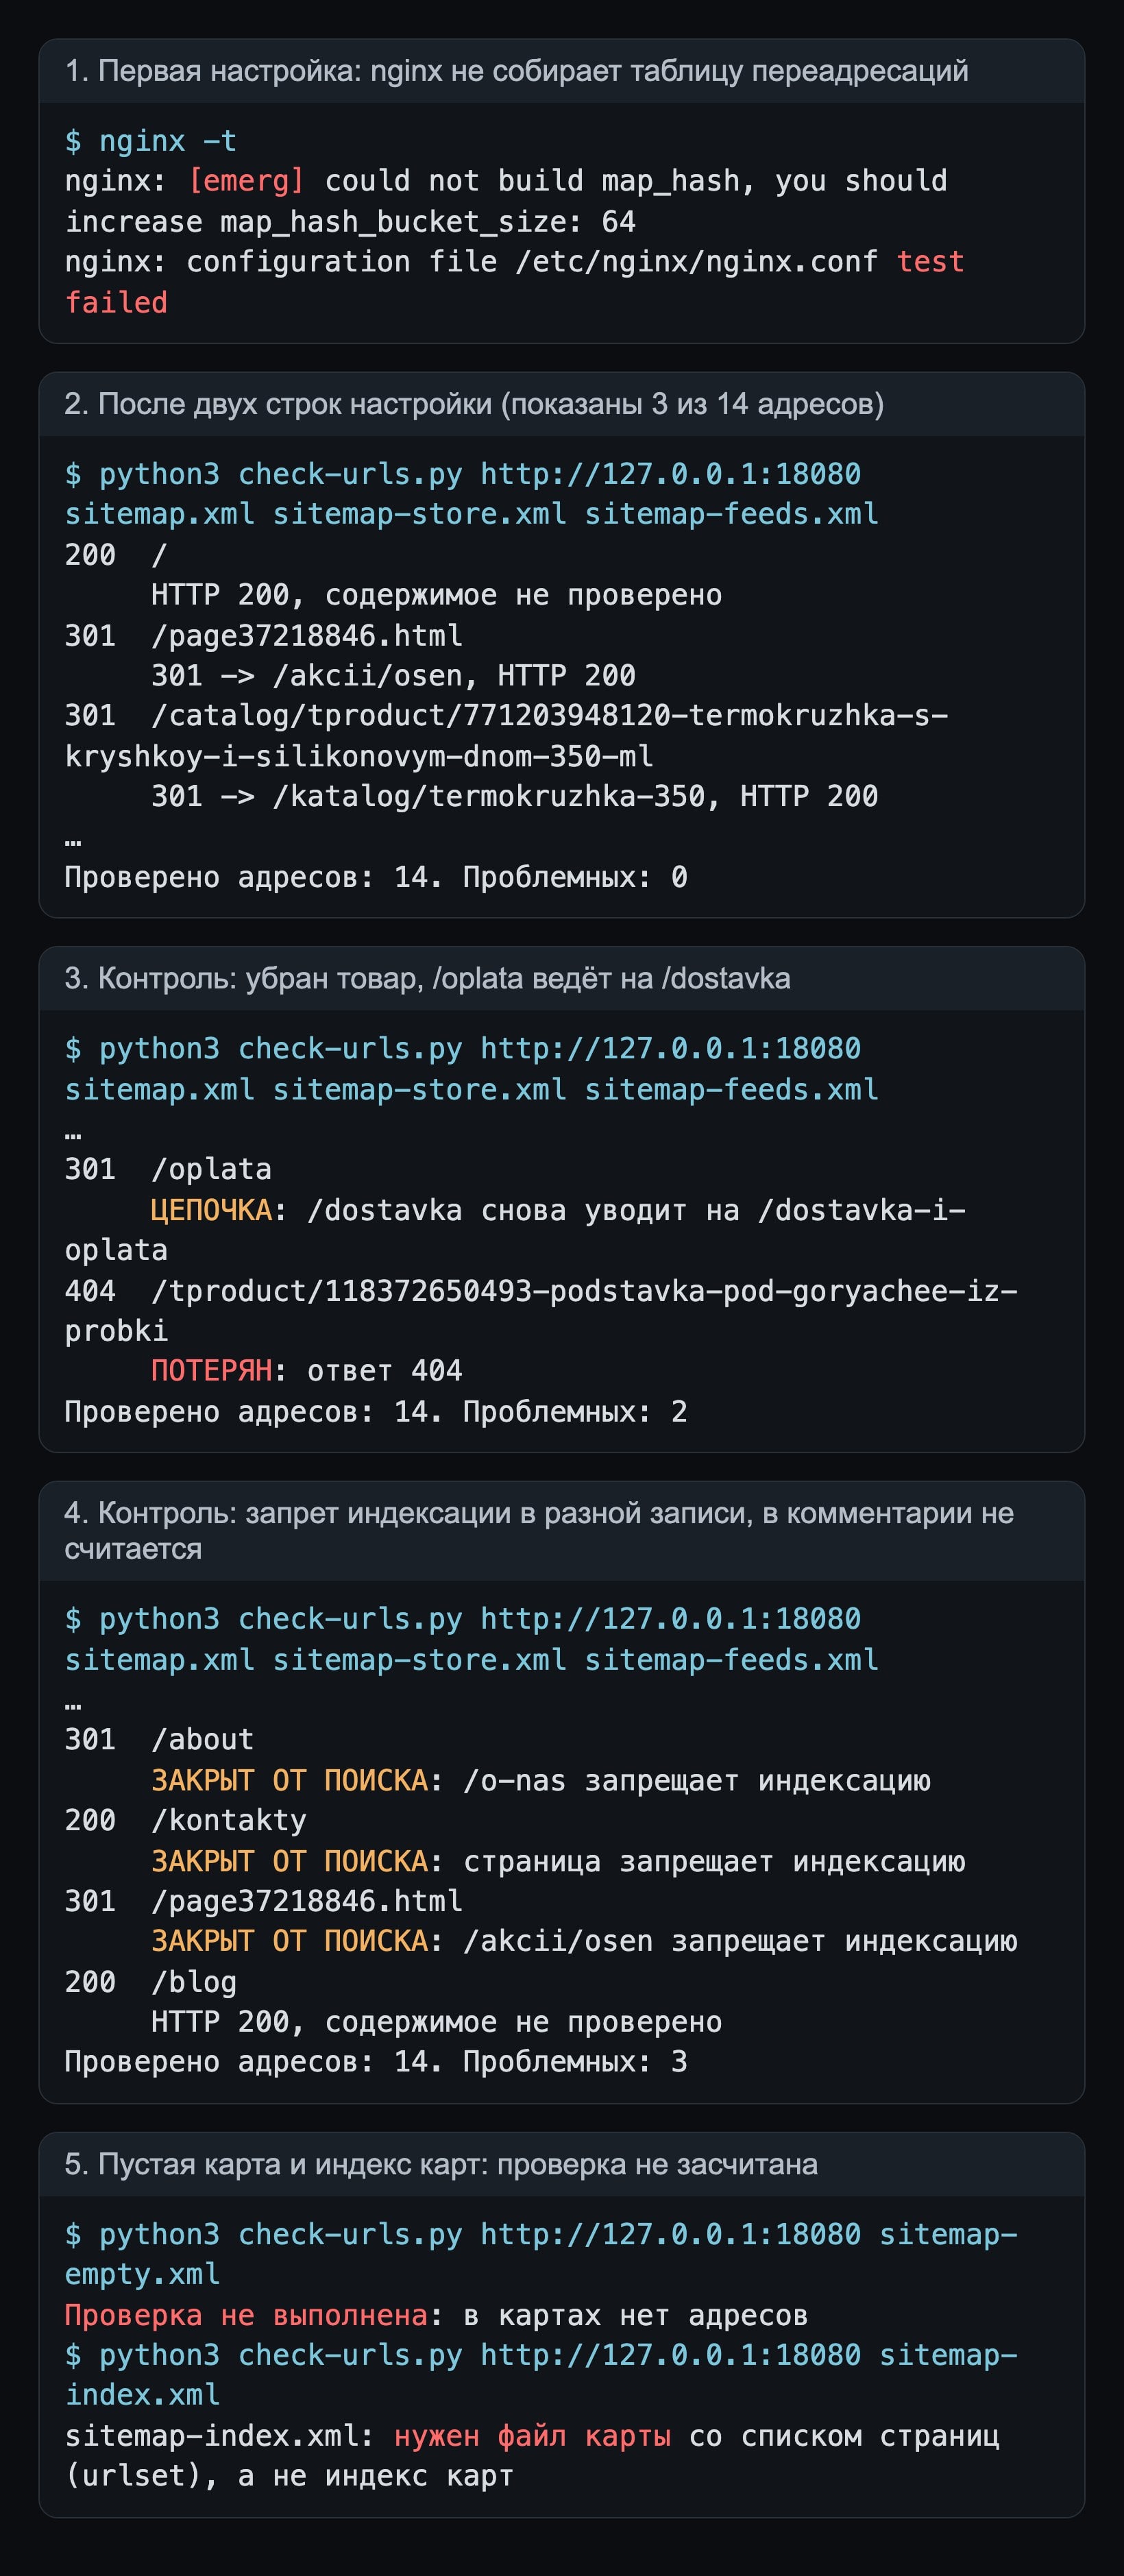
На учебном стенде проверили 14 адресов в формате Тильды. Сначала nginx не собрал таблицу длинных адресов. После первой правки все 11 переадресаций оказались тупиками: терялся порт стенда. Обе ошибки исправили двумя строками настройки.
В контрольных прогонах убрали товар, добавили цепочку переадресаций, отправили товар на главную и закрыли страницы от индексации четырьмя способами. Скрипт нашёл все поломки. Пустую карту и индекс карт он отклонил.
Скрипт проверяет ответы сервера и ищет запрет индексации в ответе страницы. Сверьте число проверенных адресов со списком и откройте ключевые страницы. Ноль найденных ошибок ещё не подтверждает сохранность содержимого и доступность для поиска.
Частые вопросы
С чего начать
Выпишите функции сайта и то, что команда меняет сама. Для достройки оцените отдельную задачу. Для переезда приложите этот список и старые адреса к техническому заданию, затем сравните сметы на одинаковый состав работ.
Файлы для исполнителя
Ниже настройка nginx и скрипт проверки. Карту переадресаций держите отдельным файлом, настройки подключайте внутри секции http.
# На стенде nginx 1.27.5 arm64 при ячейке 64 байта ключ из 46 ASCII-символов
# проходил, из 47 уже нет; адреса товаров на стенде до 80, поэтому 128
map_hash_bucket_size 128;

map $uri $redirect_to {
    default "";
    include /etc/nginx/redirects.map;
}

server {
    listen 80;
    server_name _;
    absolute_redirect off;  # Location: /katalog, без схемы, хоста и порта
    root /usr/share/nginx/new-site;

    if ($redirect_to) {
        return 301 $redirect_to;
    }

    location = / { try_files /index.html =404; }
    location / { try_files $uri $uri.html =404; }
}# Старый адрес на Тильде Новый адрес /catalog /katalog; /about /o-nas; /dostavka /dostavka-i-oplata; /oplata /dostavka-i-oplata; /page37218846.html /akcii/osen; /tproduct/918293746512-chaynik-steklyannyy-s-dvoynymi-stenkami-600-ml /katalog/chaynik-steklyannyy-600; /tproduct/402918375561-nabor-kruzhek-iz-borosilikatnogo-stekla-4-sht /katalog/nabor-kruzhek-4; /catalog/tproduct/771203948120-termokruzhka-s-kryshkoy-i-silikonovym-dnom-350-ml /katalog/termokruzhka-350; /tproduct/118372650493-podstavka-pod-goryachee-iz-probki /katalog/podstavka-probka; /blog/tpost/r7xk2m9vb1-kak-vybrat-chaynik-dlya-ofisa /blog/kak-vybrat-chaynik; /blog/tpost/b3hn8c1za1-chem-otmyt-nakip-bez-himii /blog/kak-otmyt-nakip;
#!/usr/bin/env python3
"""Сверка адресов старого сайта с новым после переезда.

Запуск:  python3 check-urls.py https://новый-адрес.by sitemap.xml [sitemap-store.xml ...]
Карты сайта сохраните со старого сайта ДО переключения домена.
Для каждого старого адреса скрипт спрашивает новый сервер и печатает,
что получит поисковик: страницу (200), постоянную переадресацию (301) и куда,
или потерю (404). Проверяет ответы сервера и запрет индексации,
но не содержимое страниц: его сверяют глазами. Ничего не меняет, только читает.
"""
import re, sys, time, urllib.request, urllib.error, urllib.parse
import xml.etree.ElementTree as ET
from html.parser import HTMLParser

NS = '{http://www.sitemaps.org/schemas/sitemap/0.9}'


def blocks_indexing(value):
    return bool({'noindex', 'none'} & set(re.split(r'[\s,:]+', value.lower())))


class RobotsParser(HTMLParser):
    noindex = False

    def handle_starttag(self, tag, attrs):
        attrs = dict(attrs)
        if tag == 'meta' and (attrs.get('name') or '').strip().lower() == 'robots':
            self.noindex |= blocks_indexing(attrs.get('content') or '')


def response_noindex(body, headers):
    """Запрет индексации в заголовке X-Robots-Tag или в meta robots страницы."""
    parser = RobotsParser()
    parser.feed(body.decode('utf-8', errors='replace'))
    return parser.noindex or any(blocks_indexing(v) for v in headers.get_all('X-Robots-Tag', []))


class NoRedirect(urllib.request.HTTPRedirectHandler):
    def redirect_request(self, *args, **kwargs):
        return None  # переадресацию не выполняем, а показываем


opener = urllib.request.build_opener(NoRedirect)


def fetch(url):
    """Код ответа, адрес переадресации, признак запрета индексации."""
    req = urllib.request.Request(url, headers={'User-Agent': 'url-check/1.2'})
    try:
        with opener.open(req, timeout=15) as r:
            body = r.read()
            return r.status, None, response_noindex(body, r.headers)
    except urllib.error.HTTPError as e:
        return e.code, e.headers.get('Location'), False
    except Exception as e:
        return 0, str(e), False


def paths_from(files):
    paths = []
    for f in files:
        root = ET.parse(f).getroot()
        if root.tag != NS + 'urlset':
            sys.exit(f'{f}: нужен файл карты со списком страниц (urlset), а не индекс карт')
        for loc in root.iter(NS + 'loc'):
            u = urllib.parse.urlsplit(loc.text.strip())
            paths.append(u.path + ('?' + u.query if u.query else ''))
    return list(dict.fromkeys(paths))


def main():
    if len(sys.argv) < 3:
        sys.exit(__doc__)
    base = sys.argv[1].rstrip('/')
    paths = paths_from(sys.argv[2:])
    if not paths:
        sys.exit('Проверка не выполнена: в картах нет адресов')
    problems = 0
    for path in paths:
        code, location, noindex = fetch(base + path)
        if code == 200:
            verdict = 'HTTP 200, содержимое не проверено'
            if noindex:
                verdict = 'ЗАКРЫТ ОТ ПОИСКА: страница запрещает индексацию'
                problems += 1
        elif code in (301, 308) and location:
            target = urllib.parse.urljoin(base + path, location)
            target_path = urllib.parse.urlsplit(target).path
            code2, location2, noindex2 = fetch(target)
            if code2 in (301, 302, 307, 308):
                verdict = f'ЦЕПОЧКА: {location} снова уводит на {location2}'
                problems += 1
            elif code2 != 200:
                verdict = f'ТУПИК: переадресация на {location}, а там {code2 or location2}'
                problems += 1
            elif target_path == '/' and path != '/':
                verdict = 'НА ГЛАВНУЮ: поисковик может счесть страницу удалённой'
                problems += 1
            elif noindex2:
                verdict = f'ЗАКРЫТ ОТ ПОИСКА: {target_path} запрещает индексацию'
                problems += 1
            else:
                verdict = f'{code} -> {target_path}, HTTP 200'
        elif code in (302, 307):
            verdict = f'ВРЕМЕННАЯ переадресация {code} на {location}, нужна 301'
            problems += 1
        else:
            verdict = f'ПОТЕРЯН: ответ {code}'
            problems += 1
        print(f'{code:>3}  {path}\n     {verdict}')
        time.sleep(0.3)  # не торопимся: серия частых запросов похожа на атаку
    print(f'\nПроверено адресов: {len(paths)}. Проблемных: {problems}')
    sys.exit(1 if problems else 0)


if __name__ == '__main__':
main()Читайте также
Как создать сайт с помощью нейросети и проверить
Как создать сайт с помощью нейросети: лендинг с заявкой, три дефекта и лишние обещания. Прогон Claude Code, задания, исходники и проверка перед запуском.
Интеграция CRM с сайтом: как не терять заявки
Форма ушла, но менеджер не видит заявку. Как выбрать подключение к amoCRM или Битрикс24 и проверить поля, повторы, ошибки доставки до запуска рекламы.
Что такое админка сайта простыми словами
Закрытая часть сайта, где вы меняете цены и смотрите заявки. Как её называют в WordPress, Tilda и Битриксе, чем отличается от кабинета клиента и где ваша.