RAG простыми словами: когда нужна своя база

RAG (retrieval-augmented generation, генерация с поиском) это способ получать от нейросети ответы по вашим документам, не обучая её. Перед ответом система находит в документах несколько подходящих кусков и кладёт их в запрос рядом с вопросом, а модель отвечает по ним и по просьбе называет источник. Если документов и вопросов немного, а видеть документы можно всем, кто спрашивает, RAG не нужен: их можно отдать модели целиком.
Мы проверили оба способа на этом блоге. Все 52 статьи весят 245 тысяч токенов: в модель с окном на 200 тысяч они не влезли, модель с окном на миллион верно ответила на три вопроса из трёх. Учебный поиск по кускам сократил запрос примерно в сто раз, но на одном вопросе промахнулся, и по ответу не понять, что нужная статья в блоге была.
Как работает RAG, если без терминов
Представьте сотрудника с толстой папкой регламентов. Папку можно положить перед ним целиком, и ответ он найдёт, пока она не слишком толстая. А можно под каждый вопрос находить три нужных листа и давать только их. Второй способ и есть RAG:
- Нарезать. Документы заранее делят на небольшие куски, например по разделам.
- Найти. На вопрос система выбирает несколько самых похожих кусков. Рабочие системы сравнивают смысл: каждый кусок заранее превращают в набор чисел, эмбеддинг, и хранят в векторной базе.
- Ответить. Куски вместе с вопросом уходят модели с указанием отвечать только по ним.
Этим RAG выигрывает у дообучения: поменялся прайс, вы правите документ, и ответы меняются без переобучения модели.
Почему не «обучить нейросеть на своих данных»
Обычно под этим имеют в виду: пусть модель знает наши цены и правила. Дообучение (fine-tuning) решает другую задачу. В руководстве OpenAI по точности моделей проблемы разделены на две. Не хватает знаний, потому что их не было при обучении или они устарели, и тогда модели дают контекст. Ответ не в том формате или тоне, и тогда подстраивают саму модель, вплоть до дообучения.
К тому же на осень 2026 года Claude API дообучение не предлагает. OpenAI сворачивает самостоятельное дообучение: новым организациям оно закрыто с мая 2026 года, действующим клиентам закроется в январе 2027-го.
Влезут ли ваши документы в запрос целиком
Модель читает текст токенами, кусками слов. Сколько токенов она удерживает за один запрос, называют окном контекста. На осень 2026 года у старших моделей Claude окно в миллион токенов, у младшей, Haiku 4.5, в 200 тысяч.
Мы склеили все 52 статьи блога, 583 тысячи знаков, и отправили одним запросом через Claude Code. Haiku 4.5 сразу вернула ошибку: вместе со служебной частью вышло около 262 тысяч токенов. Sonnet 5 с окном на миллион прочитала всё и за 7 секунд верно ответила на вопрос по одной из статей. По разнице с пустым запросом сам блог весит 244 618 токенов.
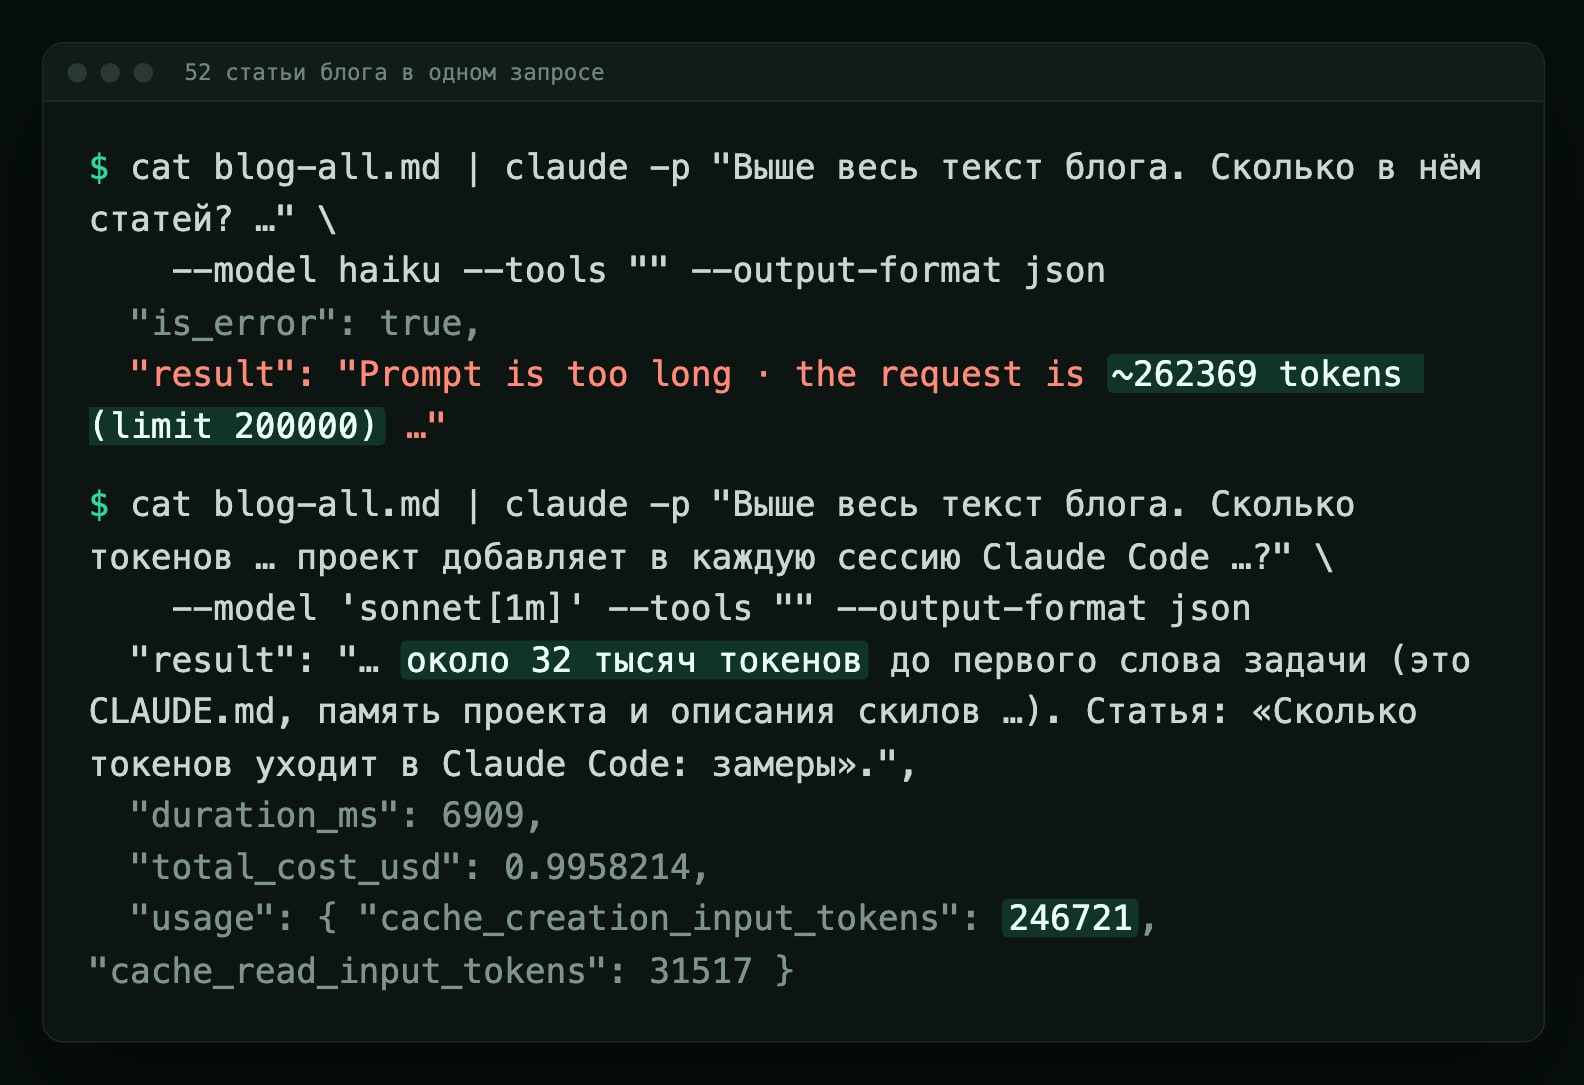
Отсюда наша пропорция для русского текста у Claude: 2,4 знака на токен. Anthropic в 2024 году оценивала 200 тысяч токенов примерно в 500 страниц. Нашего русского текста туда входит около 265 страниц по 1800 знаков, в миллион около 1300. Регламент на 200 страниц займёт около 150 тысяч токенов. Ещё место займут служебная часть инструмента и ответ модели.
Большое окно стоит денег. По прайсу Sonnet, $2 за миллион токенов, вход одного вопроса ко всему блогу стоит около $0,49. Claude Code насчитал около доллара: он каждый раз заново записывал блог в часовой кэш, а такая запись вдвое дороже обычного входа. Кэш удешевляет повторное чтение в десять раз, если документы идут неизменным блоком перед вопросом, а вопросы следуют в пределах пяти минут. У нас документы и вопрос шли одним сообщением, и второй вопрос снова оплатил весь блог.
Что показал RAG на том же блоге
Для сравнения мы написали учебный RAG: 48 строк Python без сторонних библиотек. Он режет статьи по подзаголовкам на 272 куска, ищет по совпадению слов и отдаёт модели три лучших. Те же три вопроса с той же инструкцией мы задали и всему блогу.
Три вопроса к блогу: весь текст или три куска
Сколько токенов проект добавляет в сессию?
верно, статья названа
верно, статья названа
Что делать, если нейросеть удалила данные?
верно, по нужной статье
частично, по соседней статье
Сколько стоит перевести сайт на английский?
верно: «В документах ответа нет»
верно: «В документах ответа нет»
Токенов в запросе
около 245 тысяч
1,5-2,6 тысячи
Вход вопроса без кэша, $2 за миллион (расчёт)
около $0,49
$0,003-0,005
- Перевод сайта. Такой темы в блоге нет, и оба способа ответили «В документах ответа нет». Эту фразу задала одна строка инструкции.
- Удалённые данные. Про это у нас есть статья «Почему ИИ не боится снести вашу базу». Модель с целым блогом ответила по ней. Поиск RAG её пропустил: подзаголовков в статье нет, скрипт положил её одним куском в четыре с половиной раза длиннее среднего, и слова вопроса в нём разбавлены. Кусок оказался четвёртым из 272. Модель получила три первых, ответила по соседней статье про ИИ-агентов и оговорилась, что процедуры восстановления во фрагментах нет.
По ответу промах поиска не отличить от пробела в документах: модель не знает, что лучший кусок остался за бортом. Поэтому качество поиска проверяют отдельно от ответов. А рабочие системы режут документы на небольшие куски примерно одного размера и ищут по смыслу, часто вместе с поиском по словам. Anthropic в документации пишет, что опора на документы и похожие приёмы заметно снижают выдумки, но полностью их не убирают.
Когда нужен RAG, а когда хватит запроса целиком
Пока папка регламентов тонкая, её проще отдать целиком: загрузите файлы в чат-бот, который работает с документами, и добавьте инструкцию ниже. Так можно, если база помещается в окно с запасом, вопросов в день немного и все спрашивающие вправе видеть все документы. У большой базы чат-бот может сам включить поиск по кускам, так устроены, например, проекты Claude.
Три нужных листа, то есть RAG, окупаются, когда:
- база больше окна или скоро его перерастёт;
- вопросов много, и каждый без кэша заново оплачивает всю базу;
- разным людям положены разные документы: поиск можно настроить так, чтобы чужие куски не доходили до модели;
- документов много: по документации Anthropic, чем больше текста в запросе, тем хуже модель замечает нужную деталь, и три наших удачных вопроса этого не отменяют.
Посчитать сумму заказа или проверить статус сделки RAG не может: для этого нужен ИИ-агент с доступом к вашим системам.
Здесь работает мой принцип: в погоне за упрощением часто получаешь усложнение. Нарезку, векторную базу и переиндексацию после каждой правки придётся поддерживать как отдельную систему. Помещаются документы в запрос, начинайте с запроса.
Отвечай только по документам, которые я приложил.
Если ответа в них нет, напиши: «В документах ответа нет» и ничего не додумывай.
После ответа назови документ и раздел, откуда он взят, и приведи дословно одну фразу, на которую опираешься.
Если документы противоречат друг другу, покажи оба места и не выбирай сам.
С чего начать у себя
- Посчитайте объём: знаки в документах разделите на 2,4, получите примерное число токенов для русского текста. В Word число знаков с пробелами показывает «Рецензирование → Статистика».
- Влезает с запасом и документы можно видеть всем: отдайте их целиком с инструкцией выше и задайте десять вопросов, ответы на которые знаете сами.
- Не влезает, вопросов в день сотни или доступ нужен разный: пробуйте RAG. Поиск проверьте отдельно: на двадцати вопросах посмотрите, назван ли в ответе нужный документ. Наш промах такая проверка поймала бы.
# Учебный RAG: находит в папке с документами куски, похожие на вопрос,
# и собирает из них промпт. Библиотеки не нужны, только Python 3.
# Запуск: python3 rag_demo.py <папка с .md/.txt> "ваш вопрос"
import collections, math, pathlib, re, sys

def words(text):
    # Обрезаем слова до пяти букв, чтобы «данные» и «данных» считались одним словом.
    return [w[:5] for w in re.findall(r"[а-яёa-z0-9]+", text.lower()) if len(w) > 2]

def read(f):
    try:
        return f.read_text(encoding="utf-8")
    except UnicodeDecodeError:  # файлы из старого Блокнота в Windows
        return f.read_text(encoding="cp1251")

def chunks(folder):
    # Режем каждый .md и .txt на куски по заголовкам «## ».
    # Раздел без подзаголовков станет одним длинным куском и будет искаться хуже.
    for f in sorted(pathlib.Path(folder).iterdir()):
        if f.suffix.lower() not in (".md", ".txt"):
            continue
        for part in re.split(r"\n(?=## )", read(f)):
            if part.strip():
                yield f.name, part.strip()

def search(question, docs, k=3):
    # Формула BM25: редкое слово из вопроса весит больше частого.
    n = len(docs)
    df = collections.Counter(w for _, t in docs for w in set(words(t)))
    avg = sum(len(words(t)) for _, t in docs) / n
    def score(text):
        tf = collections.Counter(words(text))
        size = sum(tf.values())
        return sum(
            math.log(1 + (n - df[w] + 0.5) / (df[w] + 0.5))
            * tf[w] * 2.2 / (tf[w] + 1.2 * (0.25 + 0.75 * size / avg))
            for w in set(words(question)) if w in tf)
    return sorted(docs, key=lambda d: score(d[1]), reverse=True)[:k]

folder, question = sys.argv[1], sys.argv[2]
docs = list(chunks(folder))
if not docs:
    sys.exit("В папке нет файлов .md или .txt")
print("Отвечай только по фрагментам ниже. Если ответа в них нет, "
      "напиши: «В документах ответа нет». В конце назови файл-источник.\n")
for name, text in search(question, docs):
    print(f"--- {name}\n{text[:2000]}\n")
print("Вопрос:", question)# Команды для macOS и Linux. Документы положите в папку docs # в формате .md или .txt, разделы начните строкой «## »: # по ним скрипт режет текст на куски. Файл Word сохраните как «Обычный текст». python3 rag_demo.py docs "Сколько стоит доставка в Гродно?" > prompt.txt # prompt.txt вставьте в чат с нейросетью или отправьте модели из терминала: claude -p "Выполни инструкцию из приложенного текста." < prompt.txt
Если документы это клиентская база из CRM, сначала посмотрите, как подключить ИИ к CRM без утечки базы. Систему, которая отвечает сотрудникам или клиентам по вашим документам с правами доступа и ссылкой на источник, я делаю в рамках AI-автоматизации.
Частые вопросы
Читайте также
Opus 5.5 vs Fable 5.1: сравнение в Claude Code
Opus 5.5 и Fable 5.1 в Claude Code на одной задаче: приёмка 57/57 у обеих, Fable на 44% дольше и в 2,4 раза дороже по ценам API. Как повторить у себя.
Нейросеть для презентаций: слайды в HTML и PDF
Нейросеть для презентаций к выступлению: мой опыт с Claude Code, 14 слайдов и проверка PDF. Где потерялся текст и что пришлось исправить перед отправкой.
Презентация результатов продаж с ИИ: что проверить
ИИ собрал презентацию продаж по таблице за 15 минут. Сверили каждый слайд: исходные числа верны, но четыре места пришлось исправить. Запрос и файлы.